
사내 데이터를 AI에 넣는 것과 학습시키는 것은 어떻게 다를까?
 Geoff Yoon
들어가며
영업이나 구매 조직에서 AI 도구를 검토한다고 해보겠습니다. 견적 문의 메일과 거래 조건이 담긴 계약서를 넣어 요약하고 회신 초안을 잡는 도구입니다. 현업에서는 업무 시간을 줄일 수 있다며 반기지만 보안이나 법무 검토 단계로 넘어가면 품의서에 질문 한 줄이 붙어 돌아오곤 합니다. “사내 데이터를 AI에 넣으면 외부 모델이 그걸 학습하는 것 아닌가요?”
도입 담당자가 공급자 측 설명이라며 “고객 데이터는 학습에 사용하지 않는다고 합니다"라고 답을 적어 넣었다고 해보겠습니다. 그래도 의사결정권자의 질문은 끝나지 않습니다. 그 설명만으로는 오늘 넣은 계약서가 어느 서버에 남는지, 검색용 복사본이 따로 생기는지, 언제 어떻게 지워지는지 알 수 없기 때문입니다.
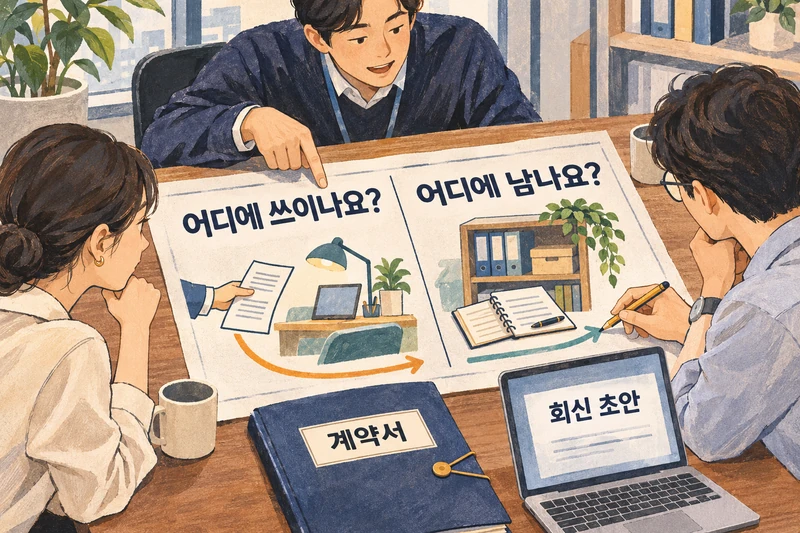
우리가 흔히 쓰는 “AI에 데이터를 넣는다"는 말 안에는 서로 다른 다섯 가지 일이 섞여 있습니다. 이번 질문에 답하기 위해 자료를 읽는 추론, 검색을 위해 문서를 쪼개 별도 저장소에 준비하는 RAG, 고객 전용 모델을 훈련하는 미세조정, 공급자의 범용 모델을 개선하는 학습, 그리고 이 과정에서 남는 운영 기록과 사본을 보관·삭제하는 일입니다.
결국 경영진이 품의서에서 확인해야 할 질문은 ‘이 데이터가 무엇에 사용되는가’와 ‘어디에 얼마나 남고 어떻게 지워지는가’라는 두 축입니다. 학습 제외 문구 하나로 보관과 삭제까지 한꺼번에 승인할 수 없는 이유를 데이터 경로별로 짚어 보겠습니다.
서류를 읽어 주는 일과 통역사를 훈련시키는 일
외부 전문 통역사에게 회의 자료를 건네는 장면을 먼저 떠올려 보겠습니다. 회의 자리에서 오늘 검토할 견적서 한 장을 보여 주고 핵심 조건만 요약해 달라고 부탁하는 상황입니다. 통역사가 눈앞의 서류를 읽고 답을 정리해 준다고 해서 그 자리에서 통역사의 머릿속 지식 체계 자체가 새로 훈련되는 것은 아닙니다.
반면 우리 회사의 과거 계약서와 분류 기준을 모아 통역사를 따로 훈련시키는 일은 별도의 계약이자 독립된 작업입니다. 통역사가 우리 서류를 자신의 일반 교본에 반영해 다른 고객사 일에 써도 되는지, 그리고 회의를 마친 뒤 서류 복사본이나 메모를 얼마나 보관하다 파기하는지는 또 따로 물어야 할 문제입니다.
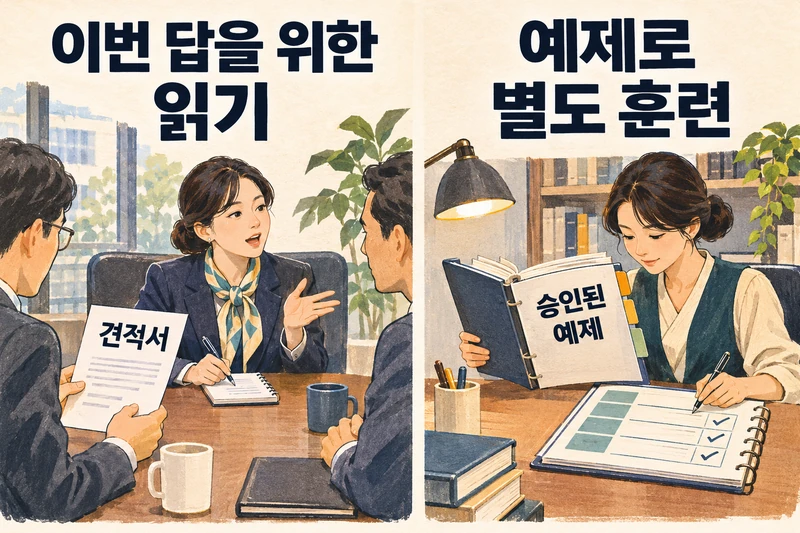
AI도 마찬가지입니다. 프롬프트나 문맥(context)에 자료를 넣어 답변을 생성하는 과정은 ‘추론(inference)‘입니다. 2026년 11월 확인 기준으로 Microsoft Azure Foundry 데이터 보호 문서 는 추론 때 모델 자체에 질문·답변이 저장되거나 가중치가 바뀌지 않는다는 설명과 서비스의 저장 기능을 분리해 안내합니다.
추론과 구분해야 할 경로는 공급자가 고객 콘텐츠를 자사 범용 모델 개선에 활용하는 일입니다. 2026년 11월 확인 기준 OpenAI API 데이터 통제 문서 는 고객이 명시적으로 데이터 공유에 옵트인(opt-in)하지 않는 한 기본적으로 API 입출력을 모델 학습·개선에 사용하지 않는다고 설명합니다. 다만 품의서에서는 실제 계약 대상과 설정을 따로 확인해야 합니다. 사용하는 제품과 계정 유형, 세부 설정에 따라 적용 규칙이 달라지기 때문입니다.
문서를 연결하는 RAG는 새 검색 창고를 짓는 일입니다
분량이 많은 규정집이나 계약 조건을 질문할 때마다 입력창에 통째로 넣기는 어렵습니다. 이럴 때는 RAG(검색 증강 생성, Retrieval-Augmented Generation)를 검토할 수 있습니다. 자료를 검색 가능한 형태로 준비해 두고 질문과 관련된 부분만 찾아 모델 입력에 붙이는 방식입니다.
원래 RAG를 제안한 논문 은 모델의 파라미터 기억과 외부 검색 기억을 결합하면서 모델을 미세조정하는 구성을 다뤘습니다. 하지만 실무에서 기존 상용 모델과 검색을 연결할 때는 생성 모델을 재학습하지 않고 검색 파이프라인을 붙이는 구성도 가능합니다.
OpenAI의 Retrieval 가이드 가 설명하듯, RAG에서 데이터를 넣는 과정은 두 단계입니다. 문서 등록 단계에서는 파일을 작은 조각으로 나누고 검색용 숫자 표현인 임베딩(embedding)을 계산해 색인(index)을 만들어 벡터 저장소에 적재합니다. 질문 단계에서는 관련 조각을 찾아 답변 생성에 사용합니다. 임베딩 계산은 문서를 검색용 숫자 표현으로 변환하는 작업이며 그 호출 자체를 생성 모델의 재학습이라고 부르면 부정확합니다.
여기서 경영진이 확인할 점이 두 가지 있습니다. 모델이 이번 질문에서 읽은 분량과 달리 검색 서비스에는 원문 조각, 임베딩, 메타데이터가 별도 사본으로 보관됩니다. 또 문서를 숫자로 바꿨다고 자동 익명화가 보장되지는 않습니다. 임베딩 역변환을 다룬 2023년 연구 는 특정 임베딩 모델과 실험 조건에서 원문 복원을 보였습니다. 모든 벡터가 항상 복원된다는 뜻은 아니지만 벡터 저장소도 보호 대상으로 관리해야 한다는 근거가 됩니다.
따라서 RAG를 도입할 때는 공개 복지 규정과 부서별 단가표를 같은 검색 권한으로 묶지 않았는지, 프롬프트 지시에만 기대지 않고 검색 단계에서 사용자 권한을 실제로 확인하는지를 점검해야 합니다.
고객 전용 미세조정과 공급자 모델 개선의 차이
실제로 모델 파라미터를 바꾸는 ‘학습’은 언제 필요할까요. 회사 고유의 분류 체계를 반복해서 맞추거나 정해진 답변 형식을 따라야 할 때는 승인된 예제로 모델을 조정하는 ‘미세조정(fine-tuning)‘을 검토할 수 있습니다. OpenAI의 지도 미세조정 안내 에서 설명하는 미세조정은 학습 예제를 업로드하고 학습 작업을 생성한 뒤 평가 자료로 비교·검증하는 별도 절차입니다. 기존 가중치를 고정하고 추가 행렬만 학습하는 LoRA(Low-Rank Adaptation) 방식도 있습니다.
여기서도 고객용 모델을 미세조정하는 일과 공급자의 범용 모델을 개선하는 일은 구분해야 합니다. 예를 들어 Azure Foundry 데이터 보호 문서 는 해당 서비스에서 고객이 미세조정한 모델이 그 고객의 전용 사용으로 제공되며 고객의 허용이나 지시 없이는 기반 모델 학습과 공급자 개선에 데이터를 쓰지 않는다고 설명합니다. 다만 여기서 ‘전용 사용’은 모델 접근 범위에 관한 설명이며 전용 물리 서버를 제공한다는 뜻으로 확대하면 안 됩니다.
미세조정을 선택하면 학습셋, 검증셋, 중간 체크포인트, 그리고 배포된 결과 모델이나 어댑터가 모두 데이터 산출물이므로 별도로 관리해야 합니다. 자주 바뀌는 계약 조건이나 규정 원문을 찾는 일은 검색과 원문 갱신 경로를 먼저 검토하고 반복되는 분류·형식 과제는 평가 기준을 마련한 뒤 미세조정을 비교하는 접근이 적절합니다.
학습하지 않아도 데이터가 남는 세 가지 경로
품의서에서는 “공급자 학습에 쓰지 않는다"는 조건이 “어디에도 보관되지 않는다"를 뜻하지는 않는다는 점을 놓치기 쉽습니다. 학습 여부와 별개로 데이터는 세 갈래로 남을 수 있습니다.
첫째는 공급자 플랫폼의 오용 감시 로그와 기능별 상태 저장입니다. 2026년 11월 확인 기준 OpenAI API 데이터 통제 문서
를 보면, API 입출력을 기본 학습에서 제외하는 것과 별개로 오용 감시 로그는 법률·피해 방지상 예외가 없는 한 기본 최대 30일간 보관될 수 있습니다. 다만 모든 API 기능의 일률적 30일 삭제를 뜻하지는 않습니다. Responses API는 기본값 또는 store=true일 때 응답 상태를 최소 30일 보관하고 파일·벡터 저장소도 별도 객체로 남습니다. 승인된 조직·프로젝트의 제로 데이터 보존(ZDR) 역시 지원 기능·모델·예외를 확인해야 하는 별도 보관 통제입니다.
둘째는 애플리케이션의 운영·추적(tracing) 기록입니다. 제품 기능 사례인 OpenAI Agents SDK의 추적 문서 를 보면, 기본 추적 기능으로 모델 생성과 도구 호출을 기록하며 해당 기록에 입력과 출력이 포함될 수 있습니다. 공급자의 API 학습 정책만 읽고 앱에서 발생하는 추적 데이터의 본문 수집 여부와 전송처를 놓치면 안 됩니다. 민감한 내용 수집을 끄는 설정과 추적 자체를 끄는 설정이 구분되기 때문입니다.
셋째는 AI의 응답을 거쳐 업무 시스템에 저장되는 경로입니다. Morgan Stanley의 2024년 6월 Debrief 발표 를 보면, 이 도구는 고객 동의를 받아 회의 메모를 만들고 주요 내용을 요약하며 재무 자문가가 재량에 따라 편집·발송할 이메일 초안을 작성하고 Salesforce에 메모를 저장한다고 설명합니다. 이처럼 공급자 모델의 학습 여부와 별개로 AI를 거친 기록이 CRM 등 업무 시스템에 어떻게 남는지도 함께 확인해야 합니다.
삭제의 시차와 실무진에게 요구할 다섯 가지 답
데이터가 여러 복사본과 파생 산출물로 나뉘어 남는다면 삭제 역시 한 번의 요청으로 끝나지 않습니다. RAG 환경에서는 원본 문서를 지웠더라도 파생 자료인 문서 조각·임베딩·색인과 캐시까지 삭제가 전달되어야 합니다. 삭제 API 성공 응답과 검색 비노출을 같은 사건으로 기록해서는 안 됩니다. OpenAI의 Retrieval 문서 에 파일 제거가 즉시 모든 검색 결과에 반영되는 것은 아니라고 명시돼 있기 때문입니다.
또한 애플리케이션의 자체 운영 로그와 백업 저장소는 검색 색인과 다른 주기로 관리됩니다. 미세조정에 썼던 학습 파일을 삭제했다는 사실만으로 이미 만들어진 모델이나 어댑터의 학습 영향까지 제거했다고 판정할 수도 없습니다. 학습 데이터와 결과 모델은 별도 산출물이므로 특정 기록의 영향을 없애야 한다면 모델 교체나 재학습 등 어떤 처리가 필요한지 공급자와 검증해야 합니다.
국내 안내도 이를 나누어 설명합니다. 개인정보보호위원회의 2026년 5월 생성형 AI 서비스 이용자를 위한 개인정보 보호 가이드 보도자료 는 학습 활용 거부, 기록 저장·삭제, 업무 자료 입력과 외부 연동을 별개 확인 항목으로 안내합니다.
도입 품의서를 검토할 때는 실무진과 공급자에게 아래 다섯 가지 질문에 대한 답을 표로 요구할 수 있습니다.
| 확인 질문 | 품의서에서 받아야 할 답의 형태 |
|---|---|
| 1. 어디에 쓰이는가 | 추론, RAG 검색, 고객용 미세조정, 공급자 모델 개선 중 목적별 허용 여부와 설정 증거(명시적 공유 옵트인 포함) |
| 2. 어떤 경로를 쓰는가 | 계약한 제품·계정·모델·엔드포인트와 상태 저장(store 등), 파일 저장, 외부 도구 연동의 실제 설정 목록 |
| 3. 어디에 얼마나 남는가 | 원문, 분할 조각, 임베딩·색인, 공급자 로그, 앱 추적 로그, 캐시·백업, CRM 등 업무 시스템의 보관 위치와 주기 |
| 4. 권한은 어떻게 전파되는가 | 원천 문서의 열람 권한과 권한 회수가 검색 단계, 운영 로그 열람자, 외부 연동 서비스까지 전달되는 방식 |
| 5. 삭제 완료는 어떻게 확인하는가 | 저장소별 처리 시각, 검색 비노출 재확인 결과, 잔여 보관 예외와 기한, 미세조정 모델의 별도 관리 방안 |
계약 확인과 함께 작은 삭제 검수를 설계해 보는 것도 유용합니다. 테스트 문서에 고유 문구를 넣어 원문·색인·검색 응답·캐시·앱 로그 중 어디에 나타나는지 확인하고 삭제나 권한 회수 뒤 같은 문구를 재검색해 각 저장소 상태를 대조하는 방법입니다. 이 같은 운영 검수는 계약을 대신하거나 모든 데이터의 완전 삭제를 증명하지는 않습니다. 그래도 설정한 삭제와 권한 변경이 어느 파생 저장소나 로그에 아직 전파되지 않았는지 찾아내는 데는 실질적인 도움이 됩니다.
나가며
사내 데이터를 AI에 넣는 일은 무조건 막아설 일도, “학습에 쓰지 않는다"는 한 문장만 보고 그대로 승인할 일도 아닙니다. 이번 질문의 답을 만드는 추론인지, 검색용 창고를 따로 준비하는 RAG인지, 고객 전용 모델을 훈련하는 미세조정인지, 공급자 범용 모델을 개선하는 일인지를 먼저 구분하고 그 뒤에 원문과 파생 자료가 어디에 얼마나 남고 어떻게 삭제되는지를 확인하면 도입 기준이 분명해집니다.
우리 조직이 검토 중인 AI 에이전트와 문서 연결 구조에서 데이터가 어떤 경로로 흐르고 어디에 남는지, 권한 통제와 삭제 검수를 실제 운영 환경에 어떻게 맞춰야 할지 고민하고 계신다면 엡실론델타(EpsilonDelta)와 상의해 보시기 바랍니다. 계약 조건과 기술 아키텍처, 현업 운영 절차를 함께 짚으며 조직에 맞는 AX 설계를 도와드리겠습니다. 언제든 contact@epsilondelta.ai 로 편하게 문의해 주십시오.